 Reeden
批量提取信息
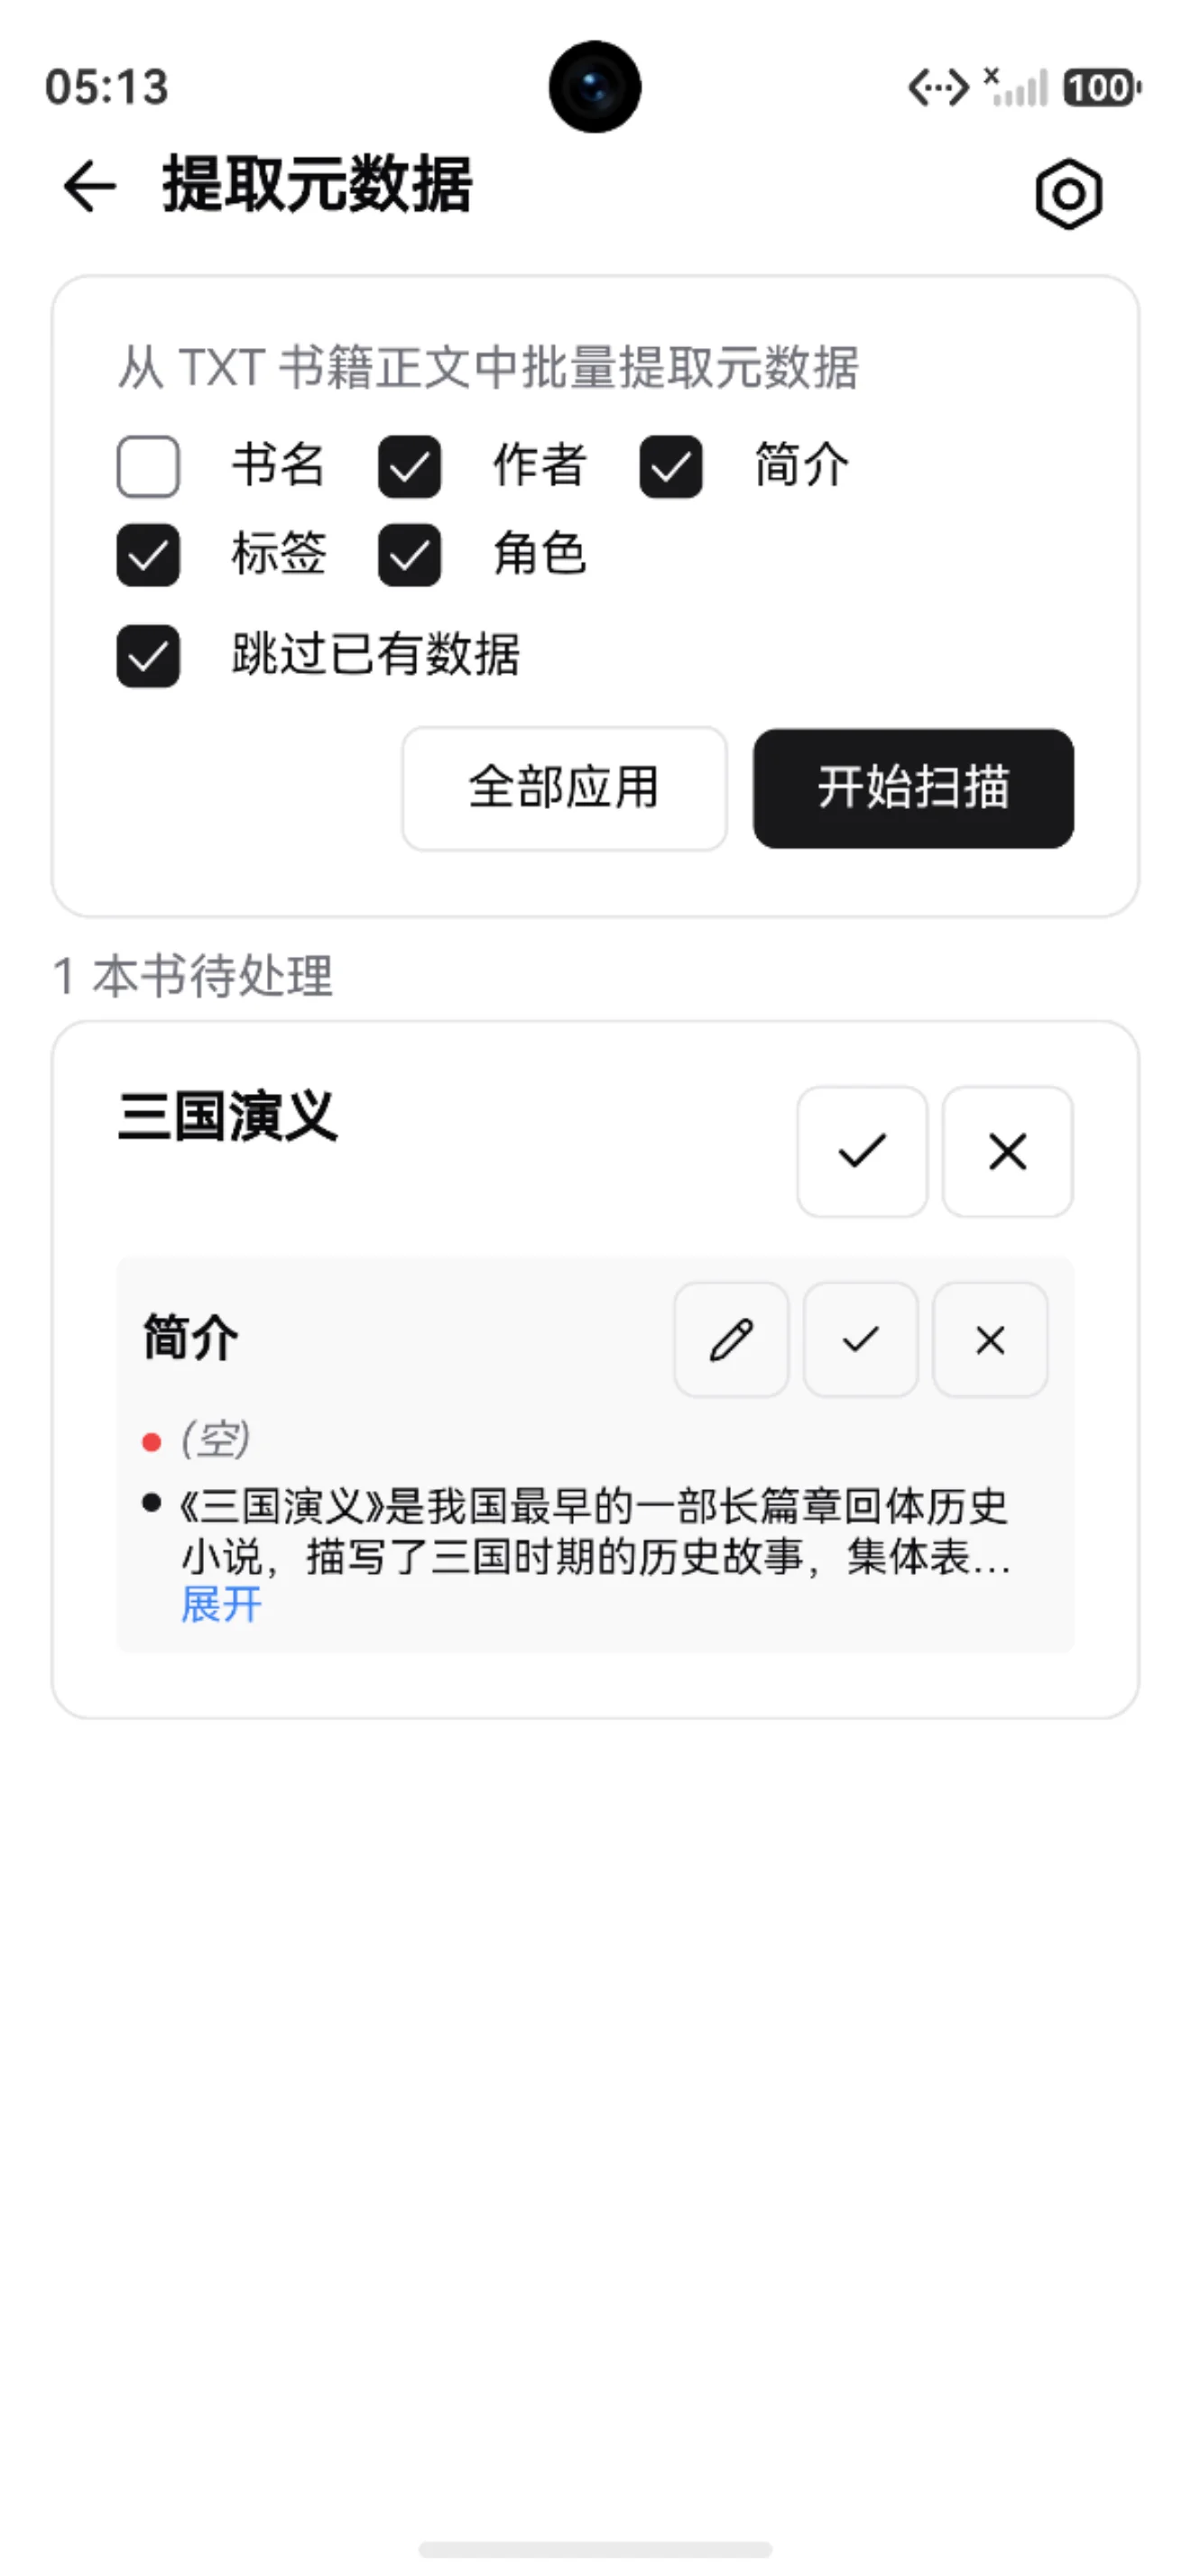
从 TXT 文件名、正文或 EPUB 自带信息中批量提取书名、作者、简介、标签和角色,重新提取已有信息,以及 EPUB 字数显示暂无时怎么统计。
批量提取适合什么
批量提取适合书籍信息不完整时使用。TXT 书会按规则从文件名和正文开头提取;EPUB 书会从书籍自带的信息里重新读取。提取后先预览,再决定是否应用。
入口:「我的 → 书库整理 → 提取元数据」。只处理部分书时,在书架上多选书籍,再从批量操作菜单里选「提取元数据」。
常见场景:
- TXT 文件名混乱,需要提取书名作者
- 简介缺失
- 标签需要从正文或文件名中整理
- 正文开头写了主角、角色或人物列表,想整理成书籍角色
- 导入了很多 TXT,需要批量补充元数据
可以提取哪些信息
常见信息包括:
- 书名
- 作者
- 简介
- 标签
- 角色
EPUB 书还可以提取译者、出版社、出版时间、ISBN。
具体可用项会受 TXT 内容结构、文件名格式和提取规则影响。EPUB 只能读到书籍文件本身写了的信息。
想重新提取已经有的信息
提取页上的「跳过已有数据」默认是勾选的:已有内容的字段不会被覆盖,只补空着的字段。
比如后来补了简介,想重新提取标签和角色,或者想用新规则覆盖旧的书名作者:
- 打开「提取元数据」
- 取消勾选「跳过已有数据」
- 扫描后在预览里确认结果,再应用
导入时不想自动提取简介、标签、角色
在「我的 → 更多设置 → 导入 → TXT 元数据提取」里,「导入自动提取」下面的「简介」「标签」「角色」可以分别关掉。关掉后导入 TXT 时不再从正文提取这一项。
已经提取出来的多余标签,可以在标签管理里删除,见 标签。
角色提取
角色提取适合正文开头有明确角色信息的 TXT,例如「主角:张三」「角色:张三、李四」这类格式。
提取后,角色会加入当前书籍的角色列表。后续可以用于书架列表显示角色、角色高亮、多角色朗读或角色相关整理。
注意:这里提取的是角色名,不是自动分析完整角色关系。如果你想让 AI 根据正文分析角色和关系,可以在 AI 助手里使用角色提取相关能力。
字数和页码在哪里处理
「批量提取信息」不负责提取页码,也不负责统计字数。
只有 TXT 会在导入时自动统计字数。EPUB、MOBI 等其他格式导入后,书籍详情里的「总字数」会显示「暂无数据」,需要手动提取一次。
批量提取字数
「我的 → 书库整理 → 提取字数」。文字书籍会提取字数,PDF 或漫画类书籍会提取页码。
它只处理还没有字数或页码、并且已经下载到本机的书。已经有字数的书不会重新统计。
单本书重新统计字数
- 在书架上打开这本书的菜单,点「信息」,进入书籍详情
- 长按「总字数」(PDF、漫画是「总页数」)
- 等提示提取完成
这本书要先下载到本机。覆盖导入换了文件、合并或调整过章节后,字数不对的,也用这个方法重新统计。
建议流程
- 先选择少量书测试
- 查看提取预览
- 确认规则是否适合这批书
- 再扩大到更多书
- 应用后检查书架和书籍详情
不同来源的书格式差异很大,不建议第一次就对整个书库应用新规则。
常见问题
书名或作者提取错了
通常是文件名或正文格式不统一。可以调整规则,或只对格式相近的一批书执行。
简介提取太长或太短
说明正文开头结构不稳定。可以先手动处理代表性书籍,再决定是否批量应用。
字数统计不准或显示「暂无」
字数统计不属于「批量提取信息」。请使用「提取字数」工具,或在书籍详情里长按「总字数」重新统计,见上面的「字数和页码在哪里处理」。
角色提取不出来
通常是角色信息没有写在正文开头,或格式和当前角色正则不匹配。可以调整角色正则,或先对格式相近的一批书测试。
操作前建议
批量应用前先导出备份。多设备使用时,批量整理完成后再同步。